
Ante la creciente demanda de tráfico y la intolerancia a los tiempos de inactividad, comparto los fundamentos técnicos para migrar una instancia monolítica como punto único de falla, a una arquitectura cloud-native resiliente, y no morir en el intento, un modelo técnico clave para garantizar que las aplicaciones crezcan de acuerdo con la demanda y, se recuperen automáticamente ante posibles fallos o incidentes de hardware, software o Zona de disponibilidad.
El uso de una sola instancia de cómputo EC2, expone a las organizaciones a tres formas críticas de indisponibilidad:
- Picos de tráfico que saturan el procesador (CPU).
- Fallas de instancia por despliegues defectuosos.
- Dependencia de una sola Zona de disponibilidad (AZ).
En este post, se describe una arquitectura de alta disponibilidad y escalabilidad horizontal basada en cuatro componentes fundamentales de AWS, diseñada para eliminar los reinicios manuales y garantizar la continuidad del negocio. La arquitectura propuesta es de mi autoría y elaboración propia, en base a mi experiencia profesional y alineada con los Marcos de referencia AWS Well-Architected Framework y AWS Architecture Best Practices.
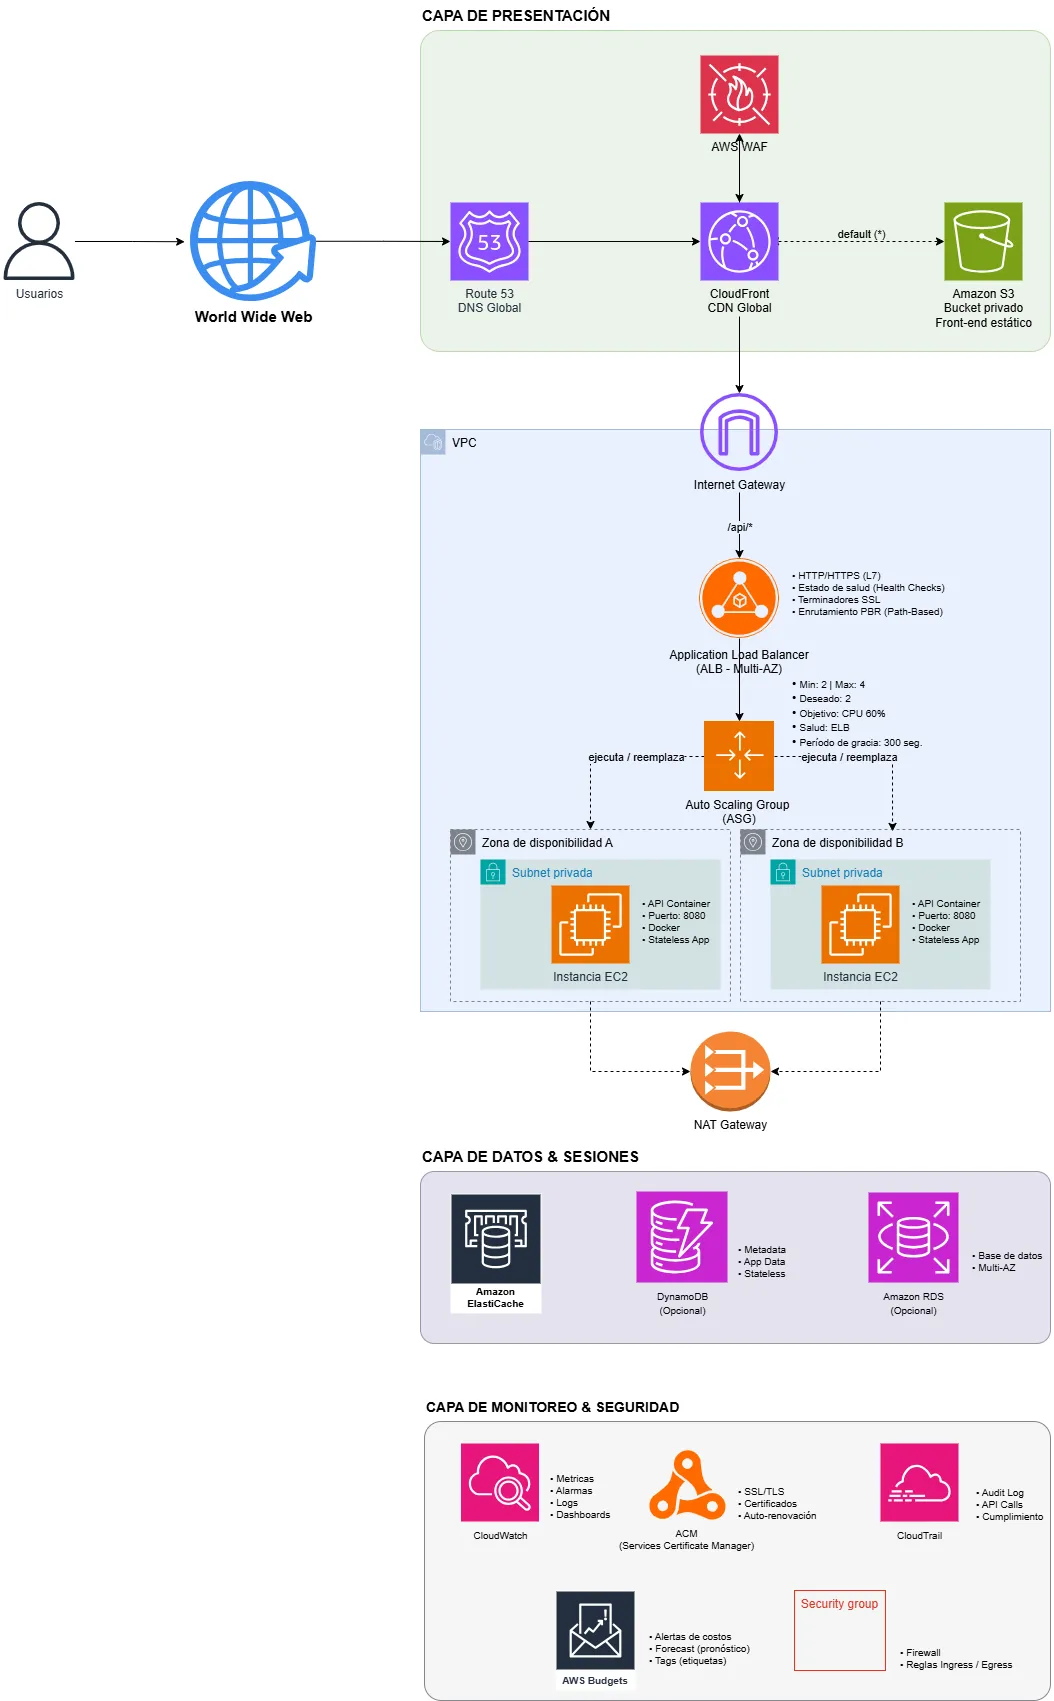
Paso 1 — Redundancia Multi-AZ. Distribución de la carga de trabajo en dos o más Zonas de disponibilidad (data centers físicamente separados con energía y red independientes); si una zona falla, la otra continúa atendiendo el tráfico sin interrupción.
Paso 2 — Enrutamiento Inteligente (Application Load Balancer). El balanceador ALB actúa como el punto de entrada único (Capa 7 – HTTP/HTTPS) distribuyendo el tráfico mediante Path-Based Routing (PBR):
- Rutas
/api/*hacia el backend dinámico.
-
default (*)hacia el bucket S3 para el contenido estático.
- Ademas, se ejecutan health checks continuos y realiza SSL Termination en el balanceador, centralizando la gestión de certificados.
Paso 3 — Elasticidad Automatizada (Auto Scaling Group). Mantiene la capacidad operativa en base a umbrales definidos:
- Mínimo: 2, una instancia por AZ.
- Máximo: 4.
- Deseado: 2.
- Target Tracking: CPU 60%.
- Health Check Type: ELB, no EC2.
- Grace Period: 300 segundos para dar tiempo de arranque a las instancias antes de evaluarlas.
Ante un fallo, se despliega un reemplazo automáticamente sin intervención de un operador humano.
Paso 4 — Descarga de contenido con CloudFront y Amazon S3. CloudFront entrega el contenido estático desde ubicaciones edge cercanas al usuario, almacenando copias en caché. De esta manera, los archivos que residen en el bucket S3 privado, son accesibles únicamente a través de AWS CloudFront mediante Origin Access Control (OAC).
Por otra parte, se propone que las rutas dinámicas por ejemplo /api/* se enruten directamente al balanceador ALB, optimizando los costos y el desempeño de la arquitectura propuesta, al separar el tráfico estático del dinámico.
🎯 Resultados y su aplicabilidad.
Por lo antes dicho, el diseño de la arquitectura AWS resultante permite:
- Cero puntos únicos de falla, con redundancia activa en múltiples AZ.
- Recuperación autónoma, detectando y reemplazando automáticamente las instancias con incidentes.
- Rendimiento optimizado, descarga de tráfico estático al edge y reducción de latencia.
- Escalabilidad bajo demanda, crecimiento horizontal controlado por métricas de negocio, tales como: RTO (Recovery Time Objective), RPO (Recovery Point Objective), MTTR (Mean Time to Repair) y MTBF (Mean Time Between Failures).
📝 Buenas prácticas críticas de diseño según los pilares de AWS Well-Architected Framework.
- Configurar el health check del Auto Scaling Group (ASG) en modo ELB y no sólo EC2, para detectar si la aplicación Web se congeló aunque el sistema operativo siga activo.
- Implementar un endpoint
/healthliviano que responda status 200 sin necesidad de consultar la base de datos.
- Configurar umbrales e intervalos adecuados, el servicio de balanceo de tráfico ALB revisa cada 30 segundos, y marca como no sanas a las instancias tras 2 fallas.
- Garantizar que la aplicación Web sea estrictamente stateless (sesiones externalizadas a ElastiCache o DynamoDB). además de implementar alertas de consumo en AWS Budgets desde el primer día, para mantener la visibilidad y control de los costos.
- Path-Based Routing en CloudFront, configurando dos orígenes en la distribución:
- El bucket S3 para contenido estático (ruta default)
- El balanceador ALB para rutas dinámicas
/api/*.
Esto optimiza costos y rendimiento de la aplicación Web, al separar el tráfico estático del dinámico.
Finalmente:
¿Suelen externalizar las sesiones de usuario en sus arquitecturas Web o aún dependen de almacenamiento local en las instancias de cómputo EC2?
¿Qué métrica utilizan como disparador principal para ejecutar sus políticas de Auto Scaling, por ejem. CPU, ALB Request Count o métricas personalizadas?
Referencias técnicas.
- Amazon Web Services. Regions and Availability Zones. AWS Documentation. https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/using-regions-availability-zones.html
- Amazon Web Services. What is an Application Load Balancer? AWS Documentation. https://docs.aws.amazon.com/elasticloadbalancing/latest/application/introduction.html
- Amazon Web Services. Health checks for your target groups. AWS Documentation. https://docs.aws.amazon.com/elasticloadbalancing/latest/application/target-group-health-checks.html
- Amazon Web Services. What is Amazon EC2 Auto Scaling? AWS Documentation. https://docs.aws.amazon.com/autoscaling/ec2/userguide/what-is-amazon-ec2-auto-scaling.html
- Amazon Web Services. Restricting access to an Amazon S3 origin (OAC). AWS Documentation. https://docs.aws.amazon.com/AmazonCloudFront/latest/DeveloperGuide/private-content-restricting-access-to-s3.html